
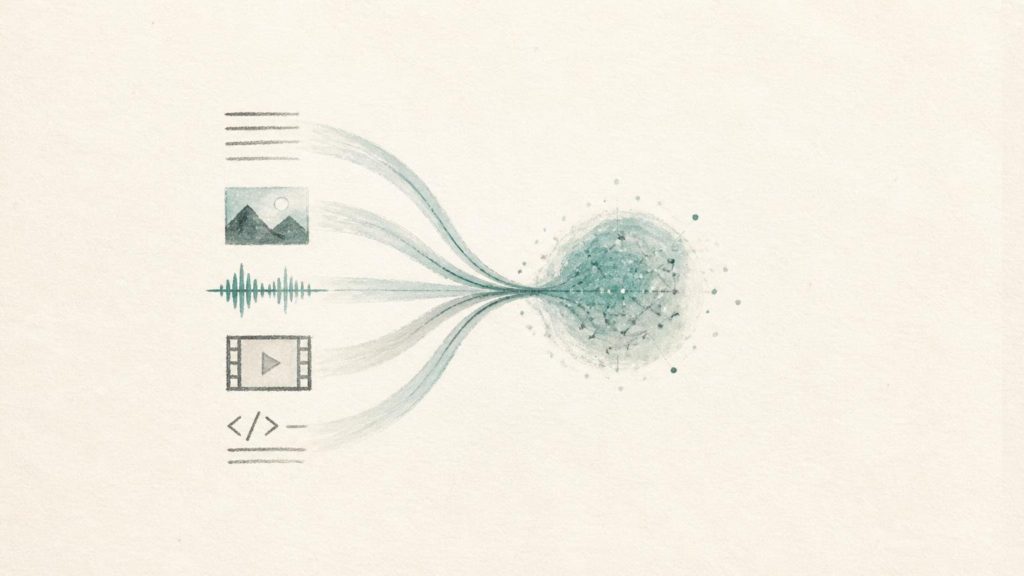
Google представила EmbeddingGemma 2 — модель для получения мультимодальных эмбеддингов на локальных устройствах. Она переводит текст, код, изображения, аудио и видео в общее пространство представлений, которое можно использовать для поиска и извлечения контекста.
Полная модель содержит 740 миллионов параметров. Модульная архитектура позволяет использовать текстовую часть отдельно, а визуальный и аудиоэнкодеры подключать при необходимости. Модель опубликована под лицензией Apache 2.0.
Google приводит сценарии поиска видео по голосовой заметке и поиска аудиофрагментов по тексту. Локальная обработка позволяет строить такие системы без обязательной отправки исходных файлов в облако. Фактические требования к памяти и скорость зависят от используемых модулей, квантования и оборудования.
Первоисточник: Google DeepMind — EmbeddingGemma 2: an open, lightweight multimodal embedding model. Дата публикации источника: .